跳到主要內容

當絕對定位遇上層疊上下文

· 閱讀需 3 分鍾

css中position: absolute可以將元素指定為絕對定位,那麼絕對定位元素的幾何位置是相對於誰計算呢?

MDN上的描述是:

絕對定位元素相對於最近的非 static 祖先元素定位。當這樣的祖先元素不存在時,則相對於ICB(inital container block, 初始包含塊)。

也即是說,絕對定位元素應該相對其position為非static的最近祖先定位,或者這樣的祖先不存在時相對初始包含快(一般為body)定位。而position默認為static。

但似乎有時候也有例外。

今天想在一個scroller組件中使用絕對定位突破到更頂層,但意外的發現,即使從該元素的父元素到body都沒有指定position屬性,它竟然仍是相對scroller容器定位而不是body或者更上層的具有position: relative屬性的元素。

實驗了半天發現是因為scroller使用了css的transform屬性來變換滾動元素的位置以提升性能。而這直接導致了具有有效transform屬性的元素成了絕對定位元素的基準。

考慮如下html:

<div style="line-height: 50px;">
<style>
.relative-container {
background: lightcoral;
position: relative;
height: 300px;
}
.midware {
background: lightcyan;
height: 200px;
}
.absolute-block {
background: black;
height: 30px;
position: absolute;
top: 0;
width: 30px;
}
</style>
<div class="relative-container">
------把下面的div撑下去一点方便观察差异-------
<div class="midware">
<div class="absolute-block"></div>
</div>
</div>
</div>
------把下面的div撐下去一點-------

如上,absolute-block成功突破了midwaretop: 0是相對於relative-container而不是其直接父元素midware。但是當我們為midware添加transform屬性後:

.midware {
background: lightcyan;
height: 200px;
transform: translateZ(0);
}
------把下面的div撐下去一點-------

absolute-block已經相對其父元素midware定位了!但midwareposition並沒有被顯示指定。transform設置為其他有效值效果也一樣。

為了測試transform屬性是否隱式改變了position屬性,我添加了如下代碼:

const el = document.querySelector('.midware');
console.log(getComputedStyle(el).position); // static

並沒有。這個現象應該是由其他機制引起的。

最後查了下資料,有人說是由層疊上下文導致的。但又不是所有的層疊上下文都會造成這樣的影響,不同內核的瀏覽器也有不同的表現。所以應該將這個特性當作bug來對待?

參考:
不受控制的 position:fixed

JS省略分號導致的災難

· 閱讀需 4 分鍾

挺長一段時間在糾結寫JavaScript代碼要不要打分號。這是一個個人風格問題,以下觀點僅代表個人喜好。

不要省略分號!不要省略分號!不要省略分號!

雖然js引擎執行代碼時會自動插入分號,但有些時候省略分號可能導致一些隱蔽的問題。

return語句

return後面會被自動插入分號,所以下面的代碼返回undefined而不是一個字符串。

function foo() {
return
"this will return undefined"
}

當然,這完全可以避免,我們可以將返回值寫在一行或者用括號包起來。

function foo() {
return (
"this is ok."
)
}

似乎這點也不是不省略分號就能避免的,如果您不清楚這條規則,下面的代碼可能會帶來疑惑:

function foo() {
return
'a long expresion' +
'another long expresion';
}
foo(); // undefined

OK,這不是重點,事實上現代編輯器足夠聰明,這樣的情況應該會將return後面的語句給你標注為灰色,你很容易就可以看到它們沒有正確的被執行。這裡只是順帶一提。我們來看更隱蔽的坑。

函數執行

考慮下面的代碼:

var foo = 0
var bar = 1

foobar()

('some condition' && 'another condition') ? foo = -1 : bar = -1

console.log(foo, bar)

function foobar() {
return function () { return false }
}

請問上面的代碼輸出什麼?答案是0 -1

我們的本意是在兩個條件滿足時給foo變量賦值-1,否則給bar變量賦值-1。這裡本該輸出-1 1,但由於語句以括號開頭,js執行引擎誤以為上一行的語句還沒有結束,正好foobar()返回了一個函數,於是上面的代碼相當於(為了更清晰我引入了一個變量):

var condition = foobar()('some condition' && 'another condition');
condition ? foo = -1 : bar = -1;

foobar()返回的函數總是返回false,所以被賦值的總是bar變量,這完全改變了我們的初衷!而且編輯器不會有提示:沒有語法錯誤。甚至運行時也不會直接出錯,而是在某個case下才命中bug。

解構賦值

接下來是我今天親身經歷的的場景。

ES2015(ES6)新增了一個解構賦值的特性,用於交換兩個變量的值那是非常的方便。例如交換a,b變量的值:[a, b] = [b, a]。當然解構賦值還有很多其他特性,可以參考MDN

考慮如下代碼:

var m = n = 0;
var swap = -1;
var matrix = [
[1, 2],
[3, 4]
];

//do something...

[matrix[m][n], swap] = [swap, matrix[m][n]]
[m, n] = [n, m]

console.log(matrix) // [[0, 2], [3, 4]]

OK,我們不用管代碼是要做什麼,反正就是想交換matrix[m][n]swap的值,再交換mn。期望的輸出應該是[[-1, 2], [3, 4]]。然鵝...

事實上在寫這篇博客之前我是贊成省略分號的。前面兩種情況我都習慣性會注意避免,也沒出過類似的錯誤。但終於還是不留神栽在了解構賦值上。

還是解釋一下,上面的解構賦值語句等價於:

[matrix[m][n], swap] = [swap, matrix[m][n]][m, n] = [n, m]

//不太清晰?由于m == n == 0,逗号表达式m,n的值为0,所以再等价于:
[matrix[m][n], swap] = [swap, matrix[m][n]] [0] = [n, m]
//即
[matrix[m][n], swap] = swap = [n, m]
//即
[matrix[m][n], swap] = [n, m]
//即
maxtrix[0][0] = 0;
swap = 0;

同樣,由於沒有語法錯誤,IDE同樣不會檢測到。

總結

暫時沒有遇到其他情況,不過有時候是防不勝防。咱一朝被蛇咬,十年怕井繩。添上分號他不香嘛。

webpack模塊加載機制

· 閱讀需 8 分鍾

前端項目的規模越來越龐大,模塊化開發已經是普遍需求。早期的打包工具將所有模塊化的代碼打包到一個bundle文件中,在一個簡單的html文件中引入腳本。webpack允許輸出為多個bundle文件,從而實現按需加載,更好的利用瀏覽器緩存,提升用戶體驗。

這裡不討論如何配置webpack,只說webpack如何加載模塊。考慮一個多頁面程序,有page1和page2兩個頁面,都用到一個工具模塊util,page1直接引用util,而page2在頁面加載後滿足一定條件時動態加載util。

//util.js
console.log('util')
export function log(arg) {
console.log(arg)
}
//page1.js
import { log } from './util'
//...
log('page1')
//page2.js
//...
//条件满足时动态加载util
import('./util').then((util) => {
util.log('page2')
})

首先明確webpack中的兩個概念:

  • module:一般是源代碼中的一個文件,打包後被包裹在一個函數中,webpack模擬了模塊環境
  • chunk:一個chunk即一個輸出bundle文件,不考慮其它分割規則,每個入口將產出一個chunk。一個chunk包含若幹module

假設我們已經配置好webpack,讓它輸出三個chunk:

0.js //util.js
page1.js //页面1
page2.js //页面2

下面從webpack的打包輸出來分析webpack模塊加載機制。

靜態依賴

webpack中,一個js源文件作為一個模塊(也可以是其他文件)。webpack將模塊代碼包裹在一個函數中,返回模塊的導出內容。注意,每個模塊最多僅被執行一次,第二次請求時會直接從緩存返回。

(打包後的)page1.js:

//立即执行函数初始化webpack运行时,然后加载入口模块
(function (modules) {
//modules是被打包到page1.js这个文件(chunk)中的模块列表,此处有page1和util两个模块
//已加载的模块的缓存
var installedModules = {};
// webpack require函数,用来加载模块
function __webpack_require__(moduleId) {
//检查模块是否已装载,是则返回缓存的模块
if (installedModules[moduleId]) {
return installedModules[moduleId].exports;
}
//将模块添加到缓存
var module = installedModules[moduleId] = {
i: moduleId, //模块ID
l: false, //模块是否已装载
exports: {} //模块的导出内容
};
// 执行模块初始化
modules[moduleId].call(
module.exports, //将模块代码的this指向其自己的exports
module, //相当于commonjs中的module,对模块自身的引用
module.exports, //相当于commonjs中的exports,模块的导出内容
__webpack_require__ //相当于commonjs中的require,提供加载同一chunk中其他模块的方法
);
// 将模块标识为已加载
module.l = true;
// 返回模块的导出内容
return module.exports;
}

//加载入口模块,即我们的page1.js
return __webpack_require__(__webpack_require__.s = "./src/page1.js");
})({
//page1模块
"./src/page1.js":
function (module, __webpack_exports__, __webpack_require__) {
let util = __webpack_require__('./src/util.js')
util.log('page1')
},

//util模块
"./src/util.js":
function (module, __webpack_exports__, __webpack_require__) {
function log (arg) {
console.log(arg)
}
//util模块导出log函数
__webpack_exports__['log'] = log
}
});

代碼被我簡化了一下,webpack有很多兼容性和安全性方面的考慮,我將那部分修改了讓代碼看起來清晰。

可以看到,util和page1被函數包圍,模擬模塊環境,然後作為參數傳遞給立即執行函數。注意,模塊只有被加載時才會執行內部代碼。

在立即執行函數中,先進行了webpack初始化,即提供核心的模塊加載函數__webpack_require__函數,並在函數上配置一些靜態字段記錄必要的信息(如__webpack_require__.s為入口模塊ID),然後裝入入口模塊,開始執行我們自己的邏輯代碼。

按需加載

在page2中我們使用了動態import()方法來加載util模塊。webpack足夠智能,無需配置它也聰明的自動將util獨立到單獨的文件(chunk),在需要時再進行請求。

webpack通過jsonp機制加載不同chunk中的模塊。

page2.js:

(function(modules) {
//模块加载函数,同page1。注意,此函数仅用于加载已被
function __webpack_require__(moduleId) {
//......
}

//可用的模块列表,包含本chunk中的模块和已经请求完毕的,来自其他chunk的模块
__webpack_require__.m = modules;
//基路径,用于拼接其他chunk的url
__webpack_require__.p = "";
//已装载的模块缓存,注意区分__webpack_require__.m,前者应该是后者的子集
var installedModules = {};
//这是相对page1中多出来的东西,用来记录其他chunk的加载情况
//值可能有3种:
// undefined, 即该chunk还没有被请求过
// 0, 该chunk中的模块已经正确的添加到__webpack_require__.m中,可以通过__webpack_require__加载了
// [resolve, reject, promise], chunk正在请求中。promise在chunk请求结束后才被resolve或reject
var installedChunks = {
"page2": 0 //page2即页面2的chunk自身,当然已经加载完成
};

//jsonp函数,chunk请求成功时由被请求的chunk调用。它的任务为将chunk中的模块加入可用模块列表
//data参数由被请求的chunk传过来,包含模块信息。这也是jsonp的核心部分
function webpackJsonpCallback(data) {
var chunkIds = data[0];
var moreModules = data[1];
var moduleId, chunkId, i = 0, resolves = [];
for(;i < chunkIds.length; i++) {
chunkId = chunkIds[i];
if(Object.prototype.hasOwnProperty.call(installedChunks, chunkId) && installedChunks[chunkId]) {
resolves.push(installedChunks[chunkId][0]);
}
//表示chunk已经加载好啦,下次不用去请求了
installedChunks[chunkId] = 0;
}
for(moduleId in moreModules) {
if(Object.prototype.hasOwnProperty.call(moreModules, moduleId)) {
//把chunk中的模块们加入可用列表(__webpack_require__.m == modules √)
modules[moduleId] = moreModules[moduleId];
}
}
//原数组的push函数,详见后文
if(parentJsonpFunction) parentJsonpFunction(data);
//resolve请求时创建的promise,执行回调
while(resolves.length) {
resolves.shift()();
}
};

//异步请求chunk
__webpack_require__.e = function requireEnsure(chunkId) {
var promises = [];
var installedChunkData = installedChunks[chunkId];
//检查chunk是否已经加载。0表示已加载
if(installedChunkData !== 0) {
//正在加载...有点不清楚为啥要重复记录一次promise?
if(installedChunkData) {
//installedChunkData[2]是之前请求的promise
promises.push(installedChunkData[2]);
} else {
//没有请求过,开始请求chunk
//标识chunkId这个chunk正在请求,并记录promise相关信息
var promise = new Promise(function(resolve, reject) {
installedChunkData = installedChunks[chunkId] = [resolve, reject];
});
promises.push(installedChunkData[2] = promise);
//现在installedChunks[chunkId] = [resolve, reject, promise]了
//用script标签加载chunk
var script = document.createElement('script');
var onScriptComplete;
script.charset = 'utf-8';
script.timeout = 120;
script.src = jsonpScriptSrc(chunkId);
//...请求错误处理...省略
//...超时处理
var timeout = setTimeout(function(){
}, 120000);
document.head.appendChild(script);
}
}
return Promise.all(promises);
};

//拼接被请求chunk的url
function jsonpScriptSrc(chunkId) {
return __webpack_require__.p + "" + ({}[chunkId]||chunkId) + ".js"
}
//通过window.webpackJsonp数组记录加载成功的chunk数据。其他chunk被加载后会将自己的chunk数据push到这个数组
var jsonpArray = window["webpackJsonp"] = window["webpackJsonp"] || [];
//注意,webpack覆盖了window.webpackJsonp数组的push函数。将原生的push函数替换成了webpackJsonpCallback
//在webpackJsonpCallback函数中我们看到有调用parentJsonpFunction,其实那个函数才是原来的数组的push函数
var oldJsonpFunction = jsonpArray.push.bind(jsonpArray);
jsonpArray.push = webpackJsonpCallback;
//理论上说这时jsonpArray应该是空的。。但如果不是空的就手动调用下webpackJsonpCallback装载chunk
//window["webpackJsonp"]已经被webpack污染啦,所以它复制了一下?
jsonpArray = jsonpArray.slice();
for(var i = 0; i < jsonpArray.length; i++) webpackJsonpCallback(jsonpArray[i]);
var parentJsonpFunction = oldJsonpFunction;

//加载入口模块
return __webpack_require__(__webpack_require__.s = "./src/page2.js");
})
({
//页面2
"./src/page2.js":
(function(module, exports, __webpack_require__) {
//我们的动态import()被webpack转化后大致代码
//先请求包含util的chunk
__webpack_require__.e(0)
//请求成功之后通过__webpack_require__加载util模块
.then(__webpack_require__.bind(null, 0))
//执行我们自己的逻辑代码
.then((util) => {
util.log('page2')
})
})
});

代碼仍然有點長,不過已經刪除和修改了很多邊緣代碼,並且調整了一下順序,結構比較清晰了。代碼中的注釋解釋了整個模塊加載過程。先通過jsonp請求得到chunk數據,然後緩存chunk中的模塊到可用列表(未裝載),這時同步的模塊加載已經可用,直接調用__webpack_require__加載相關模塊,步驟就和page1一樣了。

被加載的chunk結構就很簡單了,只是簡單的調用jsonp函數傳入模塊數據。

//0.js

//注意,前面说了,window["webpackJsonp"]数组的push函数被webpack重写了
//所以实际上这里调用了主模块那边定义的webpackJsonpCallback函数
//一个chunk可能包含多个模块,所以参数为 [moduleIds],moreModules
(window["webpackJsonp"] = window["webpackJsonp"] || []).push([[0], {
"./src/util.js":
(function (module, __webpack_exports__, __webpack_require__) {
"use strict";
__webpack_exports__['log'] = function (arg) {
console.log(arg)
}
})
}]);

總結

當項目規模增長到一定程度,模塊化已是剛需。在ESModule標準制定之前廣泛使用的模塊化標準有commonjs,AMD,以及綜合兩者的UMD等。在ES6中模塊化終於得到標準的支持,然而各平臺對其的支持有限,暫時還難以替代傳統解決方案。萬幸,webpack提供了綜合各種模塊化標準的機制,讓我們能夠平穩的過渡。

LeetCode之旅——字母異位詞分組(Group Anagrams)

· 閱讀需 2 分鍾

題目

給定一個字符串數組,要求將相同字母組成的字符串分組返回。字符串只由小寫字母組成。

示例:

Input: ["eat", "tea", "tan", "ate", "nat", "bat"],
Output:
[
["ate","eat","tea"],
["nat","tan"],
["bat"]
]

思路一

將輸入的每個字符串拆成字符排序,然後利用Map分組。

/**
* @param {string[]} strs
* @return {string[][]}
*/
var groupAnagrams = function(strs) {
const map = new Map()
for (let i = 0; i < strs.length; ++i) {
const key = strs[i].split('').sort().join()
map.has(key)
? map.set(key, map.get(key).concat(strs[i]))
: map.set(key, [strs[i]])
}
return Array.from(map.values())
};

思路二

由於字符串限定只由小寫字母組成,可以構建一個長為26的“桶”,每一格存儲對應的字母出現的次數。這樣,每個字符串都被轉化為一個這樣的桶。然後把“桶”重新轉為字符串,作為Map的鍵對原字符串數組進行分組。

/**
* @param {string[]} strs
* @return {string[][]}
*/
var groupAnagrams = function (strs) {
const list = []
for (const str of strs) {
//为每个字符串构造一个“桶”
const layer = []
for (const s of str) {
c = s.charCodeAt(0)
let value = layer[c - 0x60]
value = value ? value + 1 : 1
layer[c - 0x60] = value
}
list.push(layer.join(' '))
}
//把桶字符串化后作为key对原数组进行分组
const res = new Map()
for (let i = 0; i < list.length; ++i) {
res.has(list[i])
? res.set(list[i], res.get(list[i]).concat(strs[i]))
: res.set(list[i], [strs[i]])
}
return Array.from(res.values())
};

總結

思路一更簡潔,但排序可能會消耗更多的時間。思路二利用了桶排序的思想,將排序復雜度降到了線性復雜度。在字符串較長時思路二應該會表現更好。

徹底搞懂JavaScript怪異函數——bind

· 閱讀需 7 分鍾

2020.4.30
事實上存在new.target這個變量,在函數中會指向構造函數。如果不是以new操作符調用的構造函數,new.target為undefined。因此我們可以通過new.target判斷函數是否是new操作符調用。不過各瀏覽器對bind的支持比對new.target要早,所以在bind函數的polyfill中使用new.target可能不太合適。


我們可能遇到過實現bind函數這樣的題目,但似乎並不存在完美模擬原生bind函數的可能。ECMAScript 2015中將bind創建的函數稱為exotic function object(怪異函數對象),這很適宜,因為它的確存在一些“怪異”之處。

在繼續之前我們需要先了解bind函數。這可以參考MDN的解釋:
bind() 方法創建一個新的函數,在 bind() 被調用時,這個新函數的 this 被指定為 bind() 的第一個參數,而其餘參數將作為新函數的參數,供調用時使用。

另外還需要了解new操作符的實現,同樣參考MDN的解釋:

  1. 創建一個空的簡單JavaScript對象(即{});
  2. 鏈接該對象(即設置該對象的構造函數)到另一個對象;
  3. 將步驟1新創建的對象作為this的上下文 ;
  4. 如果該函數沒有返回對象,則返回this

第2步即為對象綁定隱式原型,將對象的__proto__屬性指向構造函數的prototype,而函數默認的prototype擁有constructor屬性指向構造函數,從而實現了所謂的“鏈接構造函數”。

這裡約定一下,bind()方法的實現函數叫bind函數,創建的新函數叫做綁定函數,被封裝的原函數叫做原函數

bind函數至少有這些特性:

  1. 除非是被new操作符調用,否則原函數執行環境中的this總是為bind函數被調用時傳遞的第一個參數;
  2. 綁定函數的prototype為undefined
  3. 通過new操作符調用綁定函數時,原函數執行環境的this仍為new操作符創建的新對象,即bind函數的this綁定被忽略;
  4. 通過new操作符調用綁定函數返回的對象是原函數的實例。即:
    function func() {}
    var fBound = func.bind({});
    var foo = new fBound();
    foo instanceof func; // true

MDN推薦的bind函數的Polyfill如下(部分):

Function.prototype.bind = function(that) {
var target = this; //原函数
var args = Array.prototype.slice.call(arguments, 1); //绑定参数
var bound; //绑定函数
//实际上binder才是绑定函数,bound将其再次包装后返回
var binder = function () {
if (this instanceof bound) {
//如果是通过new操作符调用的绑定函数,则绑定函数执行环境的this指向new操作符创建的新对象,而这个对象的隐式原型指向构造函数bound的prototype
//new操作符调用,忽略bind函数绑定的this,以实际执行环境this调用原函数
var result = target.apply(
this,
args.concat(arguments)
);
if (Object(result) === result) {
//如果构造函数返回的是一个对象,返回该对象
return result;
}
return this;
} else {
//非new操作符调用,使用绑定的this
return target.apply(
that,
args.concat(arguments)
);
}
};
//计算bind函数调用时提供的绑定参数数量
var boundLength = Math.max(0, target.length - args.length);
var boundArgs = [];
for (var i = 0; i < boundLength; i++) {
boundArgs.push('$' + i);
}
//相当于返回binder。之所以用函数再包一层,应该是为了使函数的length拥有正确的值
bound = Function('binder', 'return function (' + boundArgs.join(',') + '){ return binder.apply(this,arguments); }')(binder);

//调整原型链,使绑定函数的实例仍然是能通过原函数的原型链检测(因为绑定函数实例的隐式原型(__proto__)的隐式原型指向原函数的prototype)
//如果原函数没有prototype,则绑定函数具有默认prototype,且不会被外界访问到(除非通过绑定函数的prototype属性)
if (target.prototype) {
//构造一个临时的空函数,防止绑定函数的prototype直接引用原函数的prototype。因为原函数的prototype对外界可见,具有不确定性。如果绑定函数被调用时传递一个隐式原型指向原函数prototype的this参数,直接引用原函数就会造成误判为new操作符调用
var Empty = function Empty() {};
//绑定函数.prototype->空函数实例;空函数实例.__proto__->原函数prototype
//从而实现了,通过new得到的绑定函数实例的原型链上有原函数的prototype(文章开头的特性4),但隐式原型为原函数prototype的对象不是绑定函数的实例,因为绑定函数的原型是一个内部的对象(Empty实例),不太可能作为外部某对象的隐式原型(除非是绑定函数被当作了构造函数[new操作]),从而在前面的binder函数中,根据判断绑定函数执行环境的this是否是绑定函数的实例,正确的判断出是否为new操作符调用的绑定函数
//当然这里的漏洞是,绑定函数的prototype并不是完全不可访问的,因为绑定函数是公开的,从而绑定函数的prototype也就可访问了。但这一般不会出问题,除非你写一些奇怪的代码(后面有分析到)
Empty.prototype = target.prototype;
bound.prototype = new Empty();
Empty.prototype = null;
}
return bound;
};

上面的實現已經接近完美了,幾乎也沒有更好的實現方案了。我們來看看它實現了文章開頭列出的哪些特性。

特性2,綁定函數的prototype為undefined。其實這個很容易實現,但為了實現識別new操作符,只好讓綁定函數擁有prototype。幸運的是,這對實際使用幾乎沒有影響。

特性3,通過new操作符調用綁定函數時忽略bind函數綁定的this。OK,通過new調用時一定可以識別到。

特性4,new操作符調用綁定函數返回的對象是原函數的實例。已實現,雖然原型鏈上多了一個節點,但並不影響原型鏈判斷。
原生bind函數實例的原型鏈:原函數prototype->Object.prototype->undefined
polyfill實現的bind函數實例的原型鏈:內部臨時函數Empty.prototype->原函數prototype->Object.prototype->undefined

特性1就耐人尋味了,顯然關鍵在於對new操作符調用的精確判斷。如果是new操作符調用,顯然綁定函數執行環境的this即綁定函數的實例,會被當做new操作符調用對待(忽略bind函數綁定的this)。但非new操作符調用的情況,是否一定能夠被當作一般情況對待?考慮下面的代碼:

function foo(name) {
this.name = name;
}
var obj = {};
var bar = foo.bind(obj);
const mock = Object.create(bar.prototype ? bar.prototype : null);
bar.call(mock, 'Jack');
console.log(obj.name);
var alice = new bar('Alice');
console.log(obj.name);
console.log(alice.name);
console.log(mock);

理想的輸出是:

Jack
Jack
Alice
[Object: null prototype]

原生bind函數的輸出符合預測,但polyfill實現的版本輸出:

undefined
undefined
Alice
foo { name: 'Jack' }

bar.call(Object.create(bar.prototype), 'Jack')被當作了new操作符調用。因此綁定函數忽略了綁定的this,而使用了傳入的this參數調用原函數,因此原函數中this.name = namethis指向mock,所以賦值操作發生在mock上而非obj

bind函數被成為怪異對象,怪異就怪異在其內部機制無法完全用合法的JavaScript邏輯模擬(至少我沒有找到方法)。不過上面的實現已經可用了,最後的不一致行為其實屬於“明知故犯”的怪癖代碼,實際生產活動中完全可以杜絕。

參考

https://developer.mozilla.org/zh-CN/docs/Web/JavaScript/Reference/Global_Objects/Function/bind

https://zhuanlan.zhihu.com/p/38968174

JavaScript微任務與宏任務(瀏覽器)

· 閱讀需 3 分鍾

問題描述

最近在用Ionic框架(基於Angular),有這麼一個需求:
先調用history.go(-delta)返回到某個頁面,再調用Angular的Router#navigate()導航到新的頁面。

大致代碼如下:

go(delta, url) {
history.go(delta)
this.router.navigateByUrl(url, { replaceUrl: true })
}

問題出來了,代碼執行後只返回到了之前的頁面,並沒有正確導航到url參數指定的頁面。

原因大概是,Angular監聽了popstate事件以響應瀏覽器的回退操作。然而瀏覽器的事件觸發是異步的,即history.go(delta)執行後,要等到下一輪事件循環Angular才能捕捉到回退事件,並渲染對應的組件。然而這時router.navigateByUrl()已經執行完畢,因此看到的是回退後的頁面而不是希望導航到的新頁面。

原理分析

JavaScript的事件循環主要是靠兩個隊列:宏任務(macro task)隊列和微任務(micro task)隊列。瀏覽器按下面的順序執行隊列中的任務:

macro task 1 micro task 1 micro task 2 micro task 3 ...... macro task 2 micro task 1 micro task 2 micro task 3 ......

即,在執行完宏任務後必須執行完當前的所有微任務才能執行下一個宏任務。而瀏覽器環境下,UI事件是宏任務,Promise#then()是微任務。

當go()函數被執行時,history.go(delta)執行後,popstate事件被推入宏任務隊列,然後執行navigationByUrl()。Angular的路由導航也是異步的,但在沒有路由守衛的情況下,navigateByUrl()函數發起的整個工作流程都只是微任務(可以認為是一連串立即被resolve的Promise),所以在下一個宏任務被讀取之前,新頁面的導航已經先於回退操作完成。

go函數執行過程如下:

go history.go() 宏任务队列推入popstate事件 navigateByUrl() 微任务队列推入NavigationStart ... ... 微任务队列弹出NavigationStart ... 微任务队列推入NavigationEnd ... 微任务队列弹出NavigationEnd,新页面导航完成 ... 微任务队列空 ... 宏任务弹出popstate事件,解析history.go()回退到的url 渲染回退到的页面

解決方法

知道了原理就好解決問題了。只需要等到下一次宏任務再執行新頁面的導航就好了。

go(delta, url) {
history.go(delta)
setTimeout(() => {
this.router.navigateByUrl(url, { replaceUrl: true })
}, 0)
}

注意,setTimeout和setInterval函數創建的都是宏任務。另外,這裡說的都是瀏覽器環境下的JavaScript,部分說法對nodejs並不適用。

Javascript的in操作符

· 閱讀需 1 分鍾

javascript的in操作符用於判斷某個名稱的屬性是否存在於某個對象的原型鏈中。

語法:

prop in object

prop是string類型或Symbol類型,其他類型會被轉化為string,返回值是布爾值,如果object.prop存在則返回true,否則返回false。

需要注意的是,object必須是一個對象。最容易被誤用的場景是對字符串使用in操作符,這將直接拋出一個異常:

> 'length' in 'mystring' // Uncaught TypeError: Cannot use 'in' operator to search for 'length' in mystring

如果要判斷字符串是否包含另一個字符串,請使用includes方法(ES6)。

參考:MDN Operator in

.NET 匿名函數引用局部變量導致的問題

· 閱讀需 2 分鍾

問題

寫C#窗口程序,今天遇到的問題。在工作線程(非UI線程)要操作ListView,因此使用了跨線程調用方式。

for (int i = 0; i < videos.Count; ++i)
{
this.BeginInvoke(new Action(() =>
{
var item = lvwVideos.FindItemWithText(videos[i]);
if (item != null)
lvwVideos.Items.Remove(item);
}));
}

代碼一跑給我拋出了異常,數組下標越界。原因分析如下。

分析

概念理解錯誤,C#的閉包環境並不會復制用到的局部變量。

.NET對閉包的實現是在編譯階段而不是運行階段,事實上,匿名函數中的變量 i 和 for 循環中的i就是同一個變量,由於函數返回後變量還會被匿名函數使用,它會保存在堆中而不是調用棧——不管這個變量是值類型還是引用類型(如果是引用類型即對象和對象的引用都在堆中)。

因此,循環結束後 i 的值已經超出數組 videos 的下標範圍。而BeginInvoke函數是不等待執行完畢的,因此很可能循環結束而匿名函數還沒有執行完畢。這時匿名函數從堆中取到的 i 已經不是定義匿名函數時 i 的值了。

 
用下面的代碼來說可能更清晰。

static void Main(string[] args)
{
int i = 1;
Action action = new Action(() =>
{
Console.WriteLine(i);
});
++i;
action(); // 2
}

action執行的時候訪問的 i 和Main函數中的 i 是同一個,存儲在堆中。

解決

使用Invoke

這裡最簡單的解決方法是將BeginInvoke改為Invoke。Invoke()會等待UI線程執行完畢才會繼續執行,能夠保證 i 值不會被工作線程改變。

模仿JS

將上面的代碼稍作修改:

static void Main(string[] args)
{
int i = 1;
Action action = null;
new Action<int>((n) =>
{
action = new Action(()=>
{
Console.WriteLine(n);
});
})(i);
++i;
action(); // 1
}

這相當於將 i 復制了一遍。

基於Go語言的命令行即時聊天工具——StormChat

· 閱讀需 8 分鍾

簡介

  前段時間心血來潮想學習最近的明星編程語言Golang。於是想做個聊天小程序實踐一下。程序基於TCP協議通信,更詳細的設計見設計思路

  用Golang實現了服務端程序,同時代碼抄抄改改做了個Golang客戶端,又由於輸出問題,用C++寫了個Windows控制臺的簡陋的輸出控制庫,於是客戶端在Windows上能看了(不過朋友說很醜>_<)。

  在朋友(@Billows)的鼓勵下,我們決定用C#寫一個客戶端程序,正好他在學習WPF編程,於是界面採用了WPF編寫。我負責後臺數據交互,他負責前臺界面邏輯。

  C#客戶端還使用到了JSON格式化庫Newtonsoft.Json,特此說明。

github地址:https://github.com/mattuylee/stormchat

設計思路

通信流程

  1. 發送方(客戶端或者服務器)發送數據包;
  2. 接收方(服務器或者客戶端)處理數據;
  3. 如果需要反饋,接收方發送反饋數據包;
  4. 發送方處理反饋數據(如果有)。

通信數據包結構

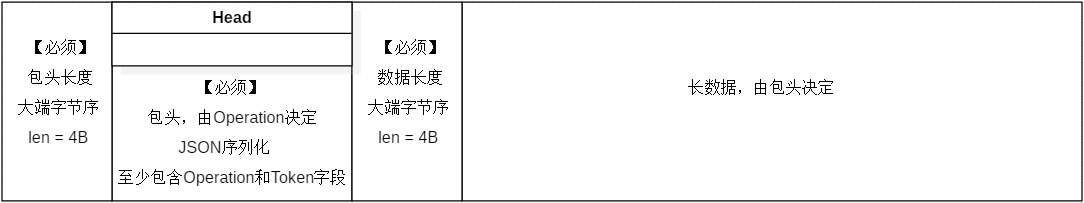
數據通信基於TCP協議,每次通信的數據包應包含【包頭域+數據域】。包頭域總是JSON格式、UTF-8編碼的字符串,數據域由包頭決定,可以為空。通信數據包結構如圖。

stormchat通信規則

HEAD(包頭域)至少包含兩個參數:

  • Toekn
  • Operation

Token參數是一次通信的標識文本,由請求方隨機生成,處理方返回數據包的Token參數應和請求方的Token參數一致(如果有返回數據)。

Operation參數指定本次通信的請求。它決定了數據包的其他數據。Operation具體行為定義見這裡

本來做了設計圖表,不過第一次用starUML,畫了一半才發現完全是鬼畫桃符,沒有掌握正確的作圖方式,也沒什麼熱情重新畫了。因此這裡不展示完整的設計文件了(本來也不完整),上面的鏈接是截取的關鍵部分(才知道starUML可以導出html文檔)。

哦,還有服務器端的數據庫結構,見文件stormchat-server/res/stormchat.sql

環境配置

  1. 開發環境

    服務器端:Windows/Linux Golang 1.11
    客戶端-Go:Windows x64,C++,Golang 1.11
    客戶端-C#:Windows,.NET4.0,WPF,Newtonsoft.Json for .NET4.0

  1. 運行環境

    服務器端:Linux/Windows, MySQL5.5+/MariaDB10.0+
    客戶端:Windows10 x64(其他平臺沒測試過)

程序配置

由於懶癌發作,一些參數設置只能在編譯時指定好,沒有運行中指定參數的功能。

Go語言的部分(服務器程序和golang客戶端程序)這塊都在control.go文件中,C#客戶端這邊也沒什麼可配置的,也就是連接服務器的地址和端口。下面列出部分配置參數:

服務器端

  • serveMode
    服務(後臺)模式。如果此參數為true,日志輸出到str_log_file參數指定的文件中,且Debug()函數將不輸出內容。如果為false,日志輸出和Debug()函數都將直接向控制臺或終端輸出。

  • max_head_length
    最大包頭長度,單位字節,如果包頭長度超過此參數將被拋棄。

  • max_message_length
    最大消息長度,單位字節,如果消息長度超過此參數將被拋棄。

  • max_photo_size
    最大頭像大小,單位字節,如果頭像數據長度超過此參數將被拋棄。

  • timeout_message
    客戶端連接最大數據等待時間,單位秒。如果超過此時間客戶端沒有數據到達則斷開連接(此參數當前未啟用)。

  • str_log_file
    日志文件。僅在serveMode為true時有效。注意,程序並不會自動清理此文件。

  • str_db_conn_str
    MySQL數據庫連接字符串。

客戶端(Go)

  • server_addr
    服務器地址和端口。

客戶端(C#)

資源定義在StormChat解決方案,Interact項目的屬性->資源中。

  • RemoteServerAddr
    服務器地址。

  • RemoteServerPort
    服務器端口。

如何編譯

首先安裝git和golang,這一步請自行解決;

克隆項目到本地:

git clone -b master https://github.com/mattuylee/stormchat.git

假設項目已克隆到本地DIR目錄,命令行切換到stormchat目錄:

cd DIR/stormchat

  1. 服務器端

切換到服務器端工程目錄:

cd stormchat-server

克隆mysql操作庫

Go標準庫裡是沒有數據庫操作的庫的,因此先添加mysql操作庫到項目中。創建目錄sotormchat-server/src/github.com/go-sql-driver/,然後克隆MySQL操作庫:

cd src/github.com/go-sql-driver
git clone https://github.com/go-sql-driver/mysql.git

配置環境變量GOPATH

Windows下:
如果環境變量GOPATH存在,則在GOPATH後添加 ";DIR/stormchat/stormchat-server"(不含引號,注意分號),如果不存在添加GOPATH環境變量並將其設置為DIR/stormchat/stormchat-server即可,注意把DIR換成git倉庫所在目錄。
Linux下:
先查看GOPATH環境變量的值,再添加項目目錄到GOPATH:

echo $GOPATH
如果值為空:
export GOPATH=DIR/stormchat/stormchat-server
如果值不為空:
export GOPATH=$GOPATH:DIR/stormchat/stormchat-server

編譯程序

切換到stormchat-server/src/stormchat/目錄,然後編譯:

cd DIR/stormchat/stormchat-server/src/stormchat
go build

配置MySQL

登錄mysql:

mysql -uroot -p

為stormchat創建數據庫:

CREATE DATABASE stormchat CHARSET=UTF8;

導入數據庫結構:

SOURCE DIR/stormchat/stormchat-server/res/stormchat.sql;

創建用戶並授權:

CREATE USER 'stormchat'@'localhost' IDENTIFIED BY 'stormchat';
GRANT ALL ON stormchat.* TO 'stormchat'@'localhost';
FLUSH PRIVILEGES;

啟動服務器程序

Linux下執行下列命令以守護進程運行:

nohup ./stormchat &

Windows請自行探索。

  1. 客戶端-Go

cd DIR/stormchat/stormchat-client-golang/src
go build

注意,客戶端運行時需要conctrl_x64.dll在運行目錄下,此文件在stormchat-client-golang/res/目錄下。

  1. 客戶端-C#

Visual Studio 2015以上版本打開項目,直接編譯即可。

注意事項

  • 沒有設計注冊賬戶的API,只能在強插數據庫。emmmm,這個坑懶得填了。
  • 服務器端的日志文件不會自動清除(反正也沒什麼日志要寫)。
  • 其他的,想到再補充。

目錄結構(主要部分)

stormchat │ .gitattributes │ .gitignore │ LICENSE //许可证 │ README.md //此帮助文件 │ ├─design //设计文件 │ message.png │ operations.svg │ stormchat.zip //starUML设计文件 │ │ ├─stormchat-server //服务器端工程目录 │ ├─res │ │ stormchat.sql //数据库结构 │ │ │ └─src //代码文件 │ └─stormchat │ control.go │ err.go │ main.go │ message.go │ session-deprecated.go //已不推荐使用的接口 │ session.go │ storm-server.go │ user.go │─stormchat-client-golang //Go客户端工程目录 │ ├─res │ │ conctrl_x64.dll //Winodws控制台输出库 │ │ icon.ico //客户端图标 │ │ │ └─src │ control.go //参数控制 │ main.go │ session.go │ stormchat-client.syso //资源文件(图标资源) │ user.go │ win-console.go //输出控制,调用conctrl库 │ └─stormchat-client-csharp //C#客户端工程目录 ├─Interact //数据交互模块 │ │ Interact.csproj //Visual Studio项目文件 │ │ Newtonsoft.Json.dll //JSON格式化库 │ │ AttrNames.cs //一些字符串常量 │ │ Client.cs //提供给数据表现模块的静态类 │ │ Client-Fields.cs //部分类,定义内部字段 │ │ Client-Handle.cs //部分类,处理服务器数据的方法 │ │ Client-Read.cs //部分类,接收服务器数据的方法 │ │ Client-Send.cs //部分类,向服务器发送数据的方法 │ │ Exception.cs │ │ jsonObject.cs //定义一些内部使用的结构,用于JSON格式化 │ │ Message.cs //定义一些数据结构,用于数据交换 │ │ User.cs //定义用户 │ │ │ └─Properties //项目属性和资源 │ AssemblyInfo.cs │ Resources.Designer.cs │ Resources.resx │ └─StormChatWPF //数据表现和用户交互模块*

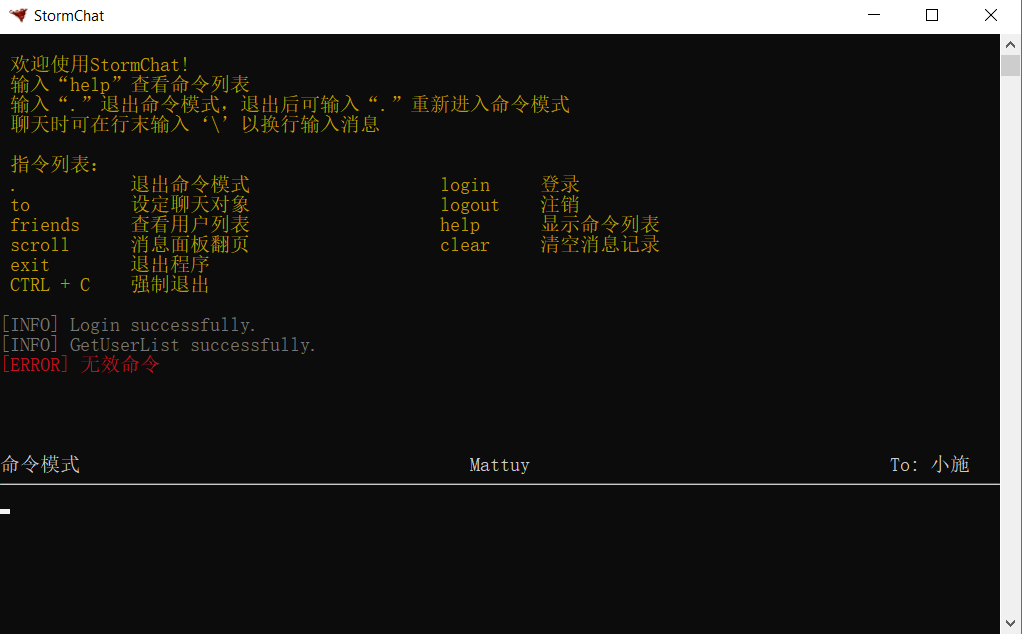
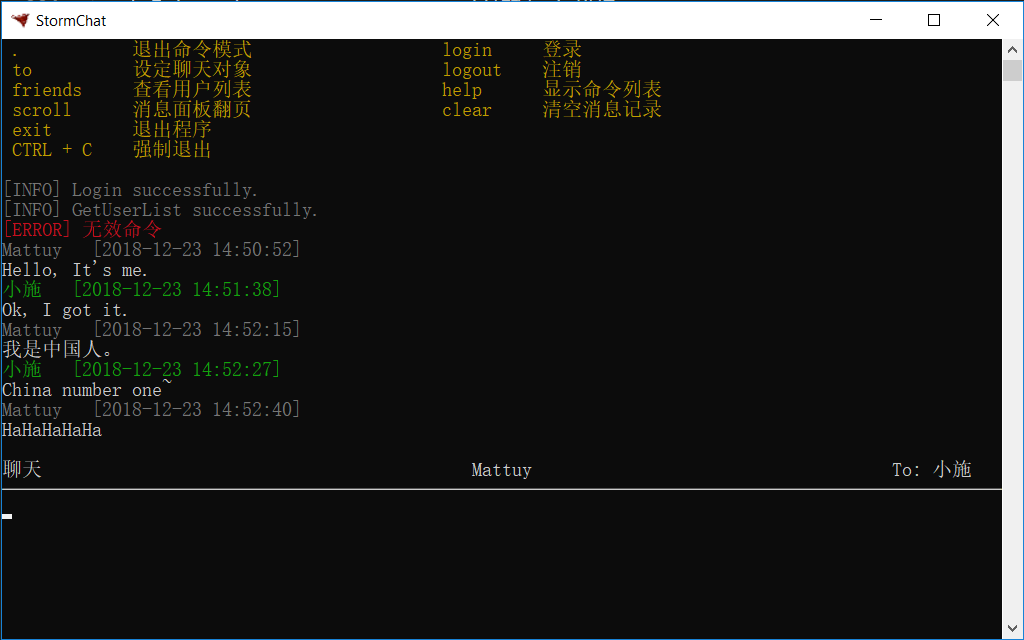
使用截圖

Golang客戶端

stormchat使用截圖
stormchat使用截圖

源代碼

github地址:https://github.com/mattuylee/stormchat

AVL樹的C語言實現

· 閱讀需 6 分鍾
// 2018-12-08
// By Mattuy
// AVL树的C语言实现
// 实现对AVL树节点的增删改查
#include <stdio.h>
#include <stdlib.h>
#include <stdbool.h>
typedef int DataType; //树的数据域

//定义AVL树
typedef struct SearchTree
{
int height; //树的深度,空树(NULL)的深度为-1
DataType value;
struct SearchTree* left;
struct SearchTree* right;
} TreeNode, SearchTree;

TreeNode* SingleRotateWithLeft(TreeNode* grandpa); //左左单旋转
TreeNode* SingleRotateWithRight(TreeNode* grandpa); //右右单旋转
TreeNode* DoubleRotateWithLeft(TreeNode* grandpa); //左右双旋转
TreeNode* DoubleRotateWithRight(TreeNode* grandpa); //右左双旋转
TreeNode* Remove(SearchTree* tree, TreeNode* node); //删除节点
void Assign(TreeNode* dest, DataType* value); //将一个节点的值赋给另外一个节点
TreeNode* Find(SearchTree* tree, DataType value); //查找节点

//获取树高度
int getHeight(SearchTree* tree);
//删除同时有左右孩子的节点时寻找子合适的子节点来顶替被删除节点
TreeNode* findExtreamNode(TreeNode* node);
//中序遍历输出AVL树
void output(SearchTree* tree);

//左左单旋转
TreeNode* SingleRotateWithLeft(TreeNode* grandpa)
{
//将祖父变为父亲的右儿子,父亲原来的右儿子变为祖父的左儿子(祖父原来的左儿子就是父亲,关系已断开)
TreeNode* parent = grandpa->left;
grandpa->left = parent->right;
parent->right = grandpa;
//新的关系是,原来的孙子和祖父变成父亲的左右儿子(孙子位置没动)。
//原祖父(现父亲右儿子)的深度取决于原父亲的右儿子和原祖父的右儿子
//父亲的深度取决于孙子和祖父(现右儿子),因此须先计算祖父(右儿子)的深度
grandpa->height = max(getHeight(grandpa->left), getHeight(grandpa->right)) + 1;
parent->height = max(getHeight(parent->left), grandpa->height) + 1;
//返回新的根节点(原来是祖父,现在是父亲)
return parent;
}
//右右单旋转
TreeNode* SingleRotateWithRight(TreeNode* grandpa)
{
TreeNode* parent = grandpa->right;
grandpa->right = parent->left;
parent->left = grandpa;
grandpa->height = max(getHeight(grandpa->left), getHeight(grandpa->right)) + 1;
parent->height = max(getHeight(parent->right), grandpa->height) + 1;
return parent;
}
//左右双旋转
TreeNode* DoubleRotateWithLeft(TreeNode* grandpa)
{
grandpa->left = SingleRotateWithRight(grandpa->left);
return SingleRotateWithLeft(grandpa);
}
//右左双旋转
TreeNode* DoubleRotateWithRight(TreeNode* grandpa)
{
grandpa->right = SingleRotateWithLeft(grandpa->right);
return SingleRotateWithRight(grandpa);
}

//插入节点,返回插入后的根节点
TreeNode* Insert(SearchTree* tree, DataType value)
{
if (tree == NULL)
{
TreeNode* temp = (TreeNode*)malloc(sizeof(TreeNode));
if (!temp)
{
return NULL;
} //申请内存失败
temp->left = temp->right = NULL;
temp->value = value;
temp->height = 0;
return temp;
} //插入新节点

if (value < tree->value)
{
tree->left = Insert(tree->left, value);
//当平衡被破坏时调整
if (getHeight(tree->left) - getHeight(tree->right) == 2)
{
//插入的节点在哪边就旋转哪边
if (value < tree->left->value)
tree = SingleRotateWithLeft(tree);
else
tree = DoubleRotateWithLeft(tree);
}
}
else if (value > tree->value)
{
tree->right = Insert(tree->right, value);
if (getHeight(tree->right) - getHeight(tree->left) == 2)
{
if (value > tree->right->value)
tree = SingleRotateWithRight(tree);
else
tree = DoubleRotateWithRight(tree);
}
}
else
return NULL; //不允许插入值相同的节点
tree->height = max(getHeight(tree-> left), getHeight(tree->right)) + 1;
return tree;
}

//删除节点
TreeNode* Remove(SearchTree* tree, TreeNode* node)
{
if (!tree || !node)
return NULL;
if (node == tree)
{
if (tree->left && tree->right)
{
//找到一个合适的子节点来替换被删除的节点
TreeNode* leaf = findExtreamNode(tree);
//记录是在左子树找的子节点还是右子树
bool doesLeft = true;
if (leaf->value > tree->value)
doesLeft = false;
//用子节点的值替代要删除节点的值
Assign(tree, leaf->value);
//删除子节点。因为现在tree节点的值和子节点一样,所以不能直接传tree节点作为参数
if (doesLeft)
tree->left = Remove(tree->left, leaf);
else
tree->right = Remove(tree->right, leaf);
tree->height = max(getHeight(tree->left), getHeight(tree->right)) + 1;
return tree;
} //被删除的节点有两个儿子
else if (!tree->left && !tree->right)
{
free(tree);
return NULL;
} //被删除的是叶子节点
else if (tree->left || tree->right)
{
TreeNode* temp = tree->left ? tree->left : tree->right;
free(tree);
return temp;
} //被删除的节点只有一个儿子
} //当前节点为待删除节点
else if(node->value > tree->value)
{
tree->right = Remove(tree->right, node);
//如果删除节点后破坏平衡,调整以重新平衡
//从右子树删除节点后进行左旋转
//如果左孩子有左孩子则进行单旋转,否则进行双旋转
if (abs(getHeight(tree->left) - getHeight(tree->right)) == 2)
tree = tree->left->left ? SingleRotateWithLeft(tree) : DoubleRotateWithLeft(tree);
} //待删除节点在右子树
else
{
tree->left = Remove(tree->left, node);
//从左子树删除节点后进行右旋转
//如果右孩子有右孩子则进行单旋转,否则进行双旋转
if (abs(getHeight(tree->left) - getHeight(tree->right)) == 2)
tree = tree->right->right ? SingleRotateWithRight(tree) : DoubleRotateWithRight(tree);
} //待删除节点在左子树
tree->height = max(getHeight(tree->left), getHeight(tree->right)) + 1;
return tree;
}

//为节点赋值
void Assign(TreeNode* dest, DataType* value)
{
dest->value = value;
}

//查找
TreeNode* Find(SearchTree* tree, DataType value)
{
TreeNode* cur = tree;
while (cur != NULL)
{
if (cur->value == value)
break;
cur = value > cur->value ? cur->right : cur->left;
}
return cur;
}

//获取树高度
int getHeight(SearchTree* tree)
{
return tree ? tree->height : -1;
}
/**
* 当被删除节点有左右孩子时找出左子树的最右节点或右子树的最左节点。务必保证传入的参数为被搜索的节点,
* 函数将根据其左右子树的深度来决定返回左孩子的最右子树还是右孩子的最左子树。
* 此函数仅应被Remove函数调用
*/
TreeNode* findExtreamNode(TreeNode* node)
{
if (node->right->height > node->left->height)
{
TreeNode* cur = node->right;
while (cur->left)
cur = cur->left;
return cur;
}
else
{
TreeNode* cur = node->left;
while (cur->right)
{
cur = cur->right;
}
return cur;
}
}
//中序遍历输出
void output(SearchTree* tree)
{
if (!tree) return;
output(tree->left);
printf("value = %d, height = %d\n", tree->value, tree->height);
output(tree->right);
}

//测试
int main()
{
SearchTree* tree = NULL;
for (int i = 1; i <= 8; i++)
tree = Insert(tree, i);
tree = Remove(tree, Find(tree, 6));
output(tree);
system("pause");
}